Stellen Sie sich vor, Sie lesen einen langen Roman, vergessen aber nach jedem Satz den Anfang der Geschichte. Es wäre unmöglich, die Handlung zu verstehen, Charaktere wiederzuerkennen oder den roten Faden zu behalten. Ein ähnliches Problem hatten lange Zeit viele Formen der Künstlichen Intelligenz, insbesondere wenn es um die Verarbeitung von Sequenzen wie Text oder Sprache ging. Die Lösung kam in Form einer genialen Architektur: Long Short-Term Memory, kurz LSTM.
Diese spezialisierten neuronalen Netze sind darauf ausgelegt, Informationen über lange Zeiträume zu speichern und abzurufen. Sie überwinden das „Kurzzeitgedächtnis“ einfacherer Modelle und ermöglichen ein tiefes kontextuelles Verständnis. In diesem Artikel erfahren Sie, wie LSTMs dieses Kunststück vollbringen, wo sie zum Einsatz kommen und warum sie ein Meilenstein in der Entwicklung des Deep Learning sind.
[ads_custom_box title=“Auf einen Blick“ color_border=“#000000″] * Das Problem: Herkömmliche Recurrent Neural Networks (RNNs) leiden unter dem „Vanishing Gradient“-Problem und können sich Informationen in langen Sequenzen nur schlecht merken.* Die Lösung: Long Short-Term Memory (LSTM) ist eine spezielle RNN-Architektur, die dieses Problem durch eine Zellenstruktur mit drei „Toren“ (Forget, Input, Output) löst.
* Der Nutzen: LSTMs können wichtige Informationen über lange Zeiträume speichern und irrelevante verwerfen. Das ermöglicht ein echtes kontextuelles Verständnis.
* Anwendungsgebiete: Die Technologie ist entscheidend für Spracherkennung, maschinelle Übersetzung, Zeitreihenanalyse und vieles mehr.
[/ads_custom_box]
Das grundlegende Problem: Das schwache Gedächtnis neuronaler Netze
Um die Genialität von LSTM zu verstehen, müssen wir zunächst das Problem kennen, das sie lösen. Sogenannte recurrent neural networks (RNNs) waren der erste Versuch, neuronale Netze mit einer Art Gedächtnis auszustatten. Sie verarbeiten Daten schrittweise und geben Informationen aus einem Schritt an den nächsten weiter. Das funktioniert gut für kurze Sequenzen.
Bei längeren Sequenzen tritt jedoch das gefürchtete Vanishing-Gradient-Problem auf. Vereinfacht gesagt: Je weiter die Information in der Kette zurückliegt, desto schwächer wird ihr Signal beim Training des Netzwerks. Das Netzwerk „vergisst“ quasi den Anfang des Satzes, was präzise Vorhersagen unmöglich macht. Aus meiner Sicht ist genau dieses Problem der Grund, warum frühe Sprachmodelle oft so unzusammenhängend wirkten.
Long Short-Term Memory (LSTM): Die Architektur des Gedächtnisses
Hier kommen LSTMs ins Spiel. Sie sind eine Weiterentwicklung von RNNs und wurden explizit entworfen, um das Problem der langfristigen Abhängigkeiten zu umgehen. Ihr Kernstück ist eine ausgeklügelte Struktur innerhalb jeder Netzwerkeinheit, die als Zelle bezeichnet wird und aus mehreren „Toren“ (Gates) besteht.
Die Zelle: Das Herzstück des LSTM
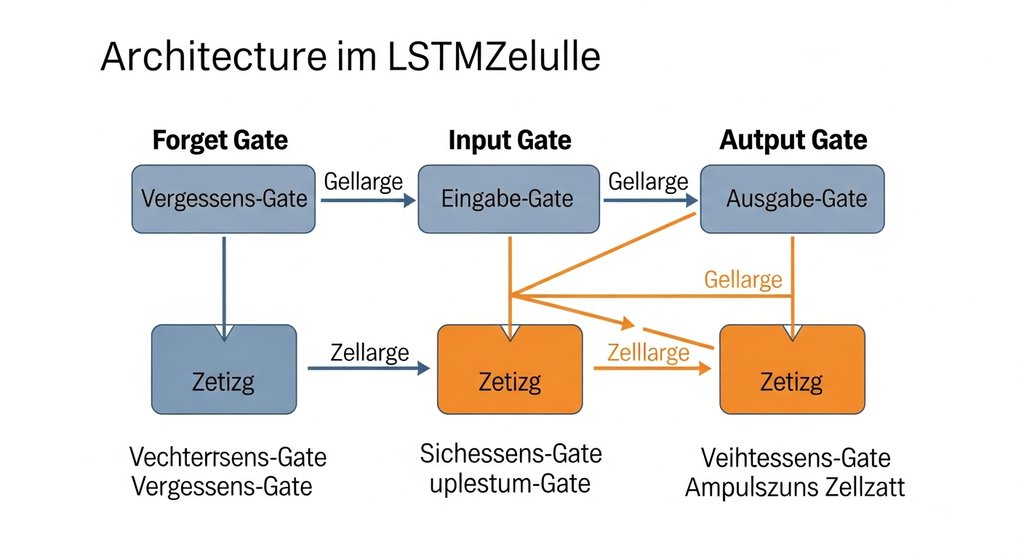
Man kann sich den Zustand der Zelle (Cell State) wie ein Förderband vorstellen, das durch die gesamte Kette läuft. Informationen können auf diesem Band transportiert, hinzugefügt oder entfernt werden. Gesteuert wird dieser Prozess durch die Tore, die lernen, welche Informationen wichtig sind und welche nicht.
Das Forget Gate (Vergessenstor): Was ist unwichtig?
Das erste Tor entscheidet, welche Informationen aus dem vorherigen Zellzustand verworfen werden sollen. Es analysiert die alte Information und den neuen Input und gibt einen Wert zwischen 0 (alles vergessen) und 1 (alles behalten) aus. So kann das Modell beispielsweise lernen, das grammatikalische Geschlecht eines Subjekts zu vergessen, sobald ein neuer Satz beginnt.
Das Input Gate (Eingangstor): Was ist neu und relevant?
Dieses Tor bestimmt, welche neuen Informationen gespeichert werden sollen. Es besteht aus zwei Teilen: Zuerst identifiziert eine Sigmoid-Schicht, welche Werte aktualisiert werden sollen. Dann erzeugt eine tanh-Schicht einen Vektor mit neuen Kandidaten-Informationen. Die Kombination beider wird dem Zellzustand hinzugefügt.
Das Output Gate (Ausgangstor): Was wird jetzt ausgegeben?
Zuletzt entscheidet das Output Gate, was aus dem aktuellen Zellzustand als Ergebnis ausgegeben wird. Basierend auf dem Input und dem gefilterten Zellzustand wird eine gezielte Information an den nächsten Zeitschritt weitergegeben. Dies ist die Vorhersage oder der Output des LSTM für diesen Schritt.
LSTM in der Praxis: Wo das Langzeitgedächtnis den Unterschied macht
Die Fähigkeit, den Kontext zu bewahren, macht LSTMs extrem leistungsfähig für eine Vielzahl von Aufgaben. Meiner Erfahrung nach ist die Fähigkeit von LSTMs, subtile, zeitliche Muster zu erkennen, der entscheidende Hebel für den Erfolg in vielen komplexen Anwendungsfällen.
- Spracherkennung: Die Bedeutung eines Wortes hängt oft vom gesamten Satz ab. LSTMs ermöglichen eine präzise Deep Learning Spracherkennung, die den Kontext versteht.
- Maschinelle Übersetzung: Um einen Satz korrekt zu übersetzen, muss das Modell die gesamte Satzstruktur und nicht nur einzelne Wörter verstehen.
- Sentiment-Analyse: LSTMs können erkennen, ob eine Produktbewertung positiv oder negativ ist, selbst wenn die entscheidenden Wörter weit auseinanderliegen (z.B. „Ich war anfangs begeistert, aber nach einer Woche … enttäuscht.“).
- Zeitreihenanalyse: In der Finanzwelt oder bei der Wettervorhersage helfen LSTMs, Muster über lange Zeiträume zu erkennen und zukünftige Entwicklungen vorherzusagen.
Die Weiterentwicklung: Von LSTM zu Transformern
Obwohl LSTMs revolutionär waren, hat die Entwicklung nicht Halt gemacht. Heute dominieren sogenannte Transformer-Modelle, wie sie in GPT-4 zum Einsatz kommen, den Bereich der Sprachverarbeitung. Sie verarbeiten Sequenzen nicht schrittweise, sondern parallel und nutzen einen „Attention“-Mechanismus, um Beziehungen zwischen allen Wörtern gleichzeitig zu bewerten.
Dennoch bleiben LSTMs ein fundamentaler Baustein und ein wichtiges Konzept im Deep Learning. Ihre Komplexität führt jedoch auch zu neuen Herausforderungen, wie sie beispielsweise das Bundesamt für Sicherheit in der Informationstechnik (BSI) in seinen Analysen beschreibt. Beim Hosting solcher Modelle ist zudem eine robuste Cloud Security unerlässlich.
Fazit: Das Gedächtnis, das die KI erwachsen werden ließ
Long Short-Term Memory war mehr als nur eine technische Verbesserung. Es war der entscheidende Schritt, der es neuronalen Netzen ermöglichte, Kontext, Zusammenhang und langfristige Abhängigkeiten zu meistern. LSTMs gaben der KI ein funktionierendes Gedächtnis und schufen damit die Grundlage für die beeindruckenden Sprach- und Sequenzmodelle, die wir heute kennen. Sie stehen für den Sprung von der reinen Mustererkennung zum beginnenden Verständnis – ein Meilenstein, der die moderne KI bis heute prägt.
Häufig gestellte Fragen
Was ist der Hauptunterschied zwischen einem LSTM und einem RNN?
Der Hauptunterschied liegt in der Zellstruktur. Ein LSTM besitzt spezielle Tore (Forget, Input, Output), die es dem Netzwerk ermöglichen, gezielt zu lernen, welche Informationen es über lange Zeit speichern und welche es vergessen soll, während ein einfaches RNN diese Kontrollmechanismen nicht hat.
Ist LSTM heute noch relevant?
Ja, absolut. Obwohl Transformer-Modelle in vielen Bereichen der Sprachverarbeitung überlegen sind, bleiben LSTMs für bestimmte Aufgaben, insbesondere bei Zeitreihenanalysen oder wenn weniger Rechenleistung zur Verfügung steht, eine sehr effiziente und relevante Technologie.
Für welche Aufgaben eignet sich LSTM nicht so gut?
LSTMs sind für die Verarbeitung von sequenziellen Daten optimiert. Für Aufgaben wie die statische Bilderkennung, bei denen es keine zeitliche oder sequentielle Komponente gibt, sind andere Architekturen wie Convolutional Neural Networks (CNNs) in der Regel besser geeignet.
Was bedeutet der „Vanishing Gradient“?
Der „Vanishing Gradient“ (verschwindender Gradient) beschreibt ein Problem beim Training tiefer Netzwerke, bei dem die Fehlerkorrektursignale auf dem Weg zurück durch die Schichten immer kleiner werden. Dadurch lernen die vorderen Schichten des Netzwerks extrem langsam oder gar nicht, was bei langen Sequenzen in RNNs zum „Vergessen“ führt.