Stellen Sie sich vor, Sie versuchen, einen Satz zu verstehen, indem Sie jedes Wort einzeln und ohne Zusammenhang betrachten. „Ich“, „gehe“, „heute“, „nicht“. Jedes Wort für sich hat eine Bedeutung, doch der wahre Sinn ergibt sich erst aus ihrer Reihenfolge. Klassische künstliche neuronale Netze stoßen hier an ihre Grenzen. Sie haben kein Gedächtnis. Recurrent Neural Networks (RNNs) sind die Antwort auf diese Herausforderung und ein fundamentaler Baustein moderner Künstlicher Intelligenz.
RNNs wurden speziell dafür entwickelt, mit sequenziellen Daten – also Informationen, deren Reihenfolge entscheidend ist – umzugehen. Sie sind das Fundament für Technologien, die wir täglich nutzen, von der Autokorrektur auf dem Smartphone bis hin zu komplexen Sprachassistenten. Dieser Artikel erklärt Ihnen die Funktionsweise, die Anwendungsgebiete und die entscheidenden Weiterentwicklungen dieser faszinierenden Technologie.
[ads_custom_box title=“Auf einen Blick“ color_border=“#000000″]- Das Prinzip: Recurrent Neural Networks (RNNs) sind eine Klasse von neuronalen Netzen, die über interne Feedback-Schleifen verfügen, um Informationen aus früheren Schritten zu speichern und zu nutzen.
- Die Funktion: Sie eignen sich ideal für die Verarbeitung von sequenziellen Daten wie Text, Sprache oder Zeitreihen, da sie ein kontextuelles Verständnis aufbauen können.
- Die Herausforderung: Traditionelle RNNs leiden unter dem „Vanishing Gradient“-Problem, was ihre Fähigkeit, langfristige Abhängigkeiten zu lernen, einschränkt.
- Die Lösung: Weiterentwicklungen wie Long Short-Term Memory (LSTM) und Gated Recurrent Units (GRU) haben dieses Problem durch spezielle „Gate“-Mechanismen gelöst.
Was genau sind Recurrent Neural Networks (RNNs)?
Ein Recurrent Neural Network ist eine spezielle Art von künstlichem neuronalem Netz, das für die Verarbeitung von Datenabfolgen konzipiert wurde. Der entscheidende Unterschied zu herkömmlichen neuronalen Netzen liegt in seiner Architektur: RNNs besitzen eine Feedback-Schleife. Diese Schleife erlaubt es dem Netzwerk, die Ausgabe eines vorherigen Schrittes als Teil der Eingabe für den aktuellen Schritt zu verwenden.
Man kann sich das wie ein Kurzzeitgedächtnis vorstellen. Wenn das Netzwerk ein Wort in einem Satz verarbeitet, berücksichtigt es nicht nur das aktuelle Wort, sondern auch eine komprimierte Information über die Worte, die davor kamen. Dieser interne Zustand, auch „Hidden State“ genannt, ermöglicht es dem RNN, Kontext aufzubauen und Muster in Sequenzen zu erkennen.
Die Architektur: Wie das „Gedächtnis“ eines RNNs funktioniert
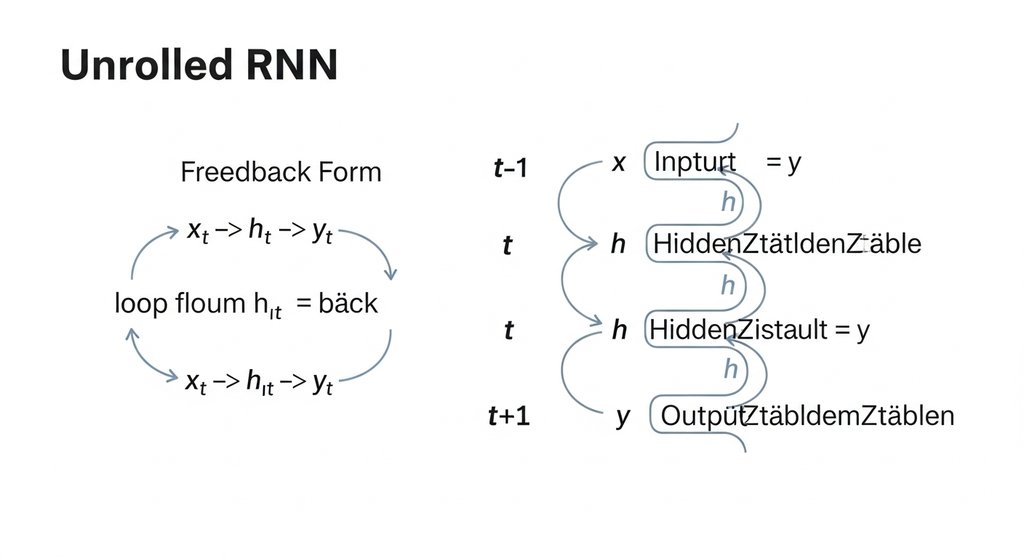
Die Magie der RNNs liegt in ihrem Aufbau. Im Kern besteht ein RNN aus sich wiederholenden Modulen, die nacheinander für jeden Zeitschritt der Sequenz ausgeführt werden. In jedem dieser Schritte geschehen zwei wesentliche Dinge:
- Eingabeverarbeitung: Das Netzwerk erhält die aktuelle Eingabe der Sequenz (z.B. ein Wort oder einen Datenpunkt einer Zeitreihe).
- Kontext-Update: Gleichzeitig empfängt es den „Hidden State“ aus dem vorherigen Zeitschritt. Dieser State enthält die gesammelten Informationen der bisherigen Sequenz. Das Netzwerk kombiniert die neue Eingabe mit dem alten State, um einen neuen Hidden State zu erzeugen, der an den nächsten Schritt weitergegeben wird.
Dieser Prozess wird durch Gewichtungsmatrizen und Aktivierungsfunktionen gesteuert, die während des Trainings mittels des Backpropagation-Algorithmus (in diesem Fall „Backpropagation Through Time“) optimiert werden. Aus meiner Sicht ist der Hidden State der entscheidende Hebel, der es einem RNN überhaupt erst ermöglicht, von Sequenzen zu lernen.
Anwendungsgebiete: Wo RNNs in der Praxis glänzen
Die Fähigkeit, sequenzielle Muster zu erkennen, macht RNNs extrem vielseitig. Meiner Erfahrung nach sind sie besonders dann die erste Wahl, wenn der unmittelbare Kontext für die Vorhersage entscheidend ist. Zu den wichtigsten Anwendungsbereichen gehören:
- Verarbeitung natürlicher Sprache (NLP): RNNs sind die Basis für maschinelle Übersetzung, Sentiment-Analyse, Textzusammenfassung und Chatbots.
- Spracherkennung: Sie wandeln gesprochene Sprache in Text um, indem sie die Abfolge von akustischen Signalen analysieren. Ein Kerngebiet des Deep Learning in der Spracherkennung.
- Zeitreihenanalyse: Von der Vorhersage von Aktienkursen über die Wetterprognose bis hin zur Analyse von Sensordaten in der Industrie – RNNs erkennen Trends und Saisonalitäten. Laut dem Fraunhofer ITWM ist die Analyse solcher Zeitreihen entscheidend für prädiktive Wartung und Prozessoptimierung.
- Generative Modelle: RNNs können auch kreativ werden und neue Sequenzen erzeugen, sei es in Form von Musikkompositionen oder der automatischen Vervollständigung von Texten.
Die Grenzen von RNNs: Vanishing & Exploding Gradients
Trotz ihrer Stärken haben klassische RNNs eine erhebliche Schwäche: Sie kämpfen mit langfristigen Abhängigkeiten. Wenn eine Information am Anfang eines langen Satzes für das Verständnis am Ende entscheidend ist, vergisst ein Standard-RNN diese oft. Der Grund dafür liegt in einem mathematischen Problem während des Trainings, das als „Vanishing Gradient“ oder „Exploding Gradient“ bekannt ist.
Beim Training wird der Fehler durch das Netzwerk zurückpropagiert. Bei langen Sequenzen wird der Gradient (die Information, wie stark die Gewichte angepasst werden müssen) immer wieder mit sich selbst multipliziert. Dadurch kann er entweder exponentiell klein werden (Vanishing Gradient) und das Lernen stoppt, oder er wird exponentiell groß (Exploding Gradient) und das Training wird instabil. In der Praxis hat sich immer wieder gezeigt, dass Standard-RNNs bei Sequenzen mit mehr als einer Handvoll Schritte an ihre Grenzen stoßen.
Die Weiterentwicklung: LSTM und GRU als Lösung
Um das Problem der vergesslichen RNNs zu lösen, wurden intelligentere Architekturen entwickelt. Die bekanntesten sind Long Short-Term Memory (LSTM) und Gated Recurrent Units (GRU). Diese Netzwerke sind im Kern immer noch RNNs, aber sie verfügen über eine komplexere interne Struktur mit sogenannten „Gates“ (Toren).
Diese Gates sind wie intelligente Ventile. Sie lernen während des Trainings, welche Informationen aus der Vergangenheit wichtig sind und gespeichert werden sollten und welche irrelevant sind und vergessen werden können. Ein Long Short-Term Memory-Netzwerk kann somit wichtige Informationen über sehr lange Sequenzen hinweg bewahren und hat die Leistungsfähigkeit von sequenziellen Modellen revolutioniert. GRUs sind eine etwas einfachere und recheneffizientere Variante davon.
In den letzten Jahren haben für viele Aufgaben, insbesondere in der Sprachverarbeitung, sogenannte Transformer-Modelle an Bedeutung gewonnen. Sie verarbeiten Sequenzen parallel statt sequenziell und können Abhängigkeiten noch effizienter modellieren. Dennoch bleiben RNNs und ihre Varianten ein zentraler Bestandteil im Werkzeugkasten des Deep Learning.
Fazit: Das Fundament für kontextuelles Verständnis
Recurrent Neural Networks waren ein Durchbruch. Sie gaben Maschinen erstmals ein Gedächtnis und ermöglichten es ihnen, sequenzielle Daten zu verstehen. Obwohl sie mit Herausforderungen wie dem Vanishing-Gradient-Problem zu kämpfen hatten, legten sie den Grundstein für fortschrittlichere Architekturen wie LSTMs und GRUs, die dieses Problem lösten. Auch wenn heute Transformer-Modelle die Schlagzeilen beherrschen, bleibt das Grundprinzip des RNNs – die Verarbeitung von Informationen im Kontext – eine der fundamentalen Ideen der modernen künstlichen Intelligenz.
Häufig gestellte Fragen
Was ist der Hauptunterschied zwischen einem RNN und einem normalen neuronalen Netz?
Der Hauptunterschied ist die interne Feedback-Schleife. Während ein normales (Feedforward-)Netzwerk Daten nur in eine Richtung verarbeitet, kann ein RNN Informationen aus früheren Zeitschritten in die aktuelle Berechnung einbeziehen und so einen Kontext aufbauen.
Wofür steht RNN?
RNN steht für Recurrent Neural Network, was auf Deutsch „rekurrentes neuronales Netz“ bedeutet. „Rekurrent“ (wiederkehrend) bezieht sich auf die Feedback-Schleife, die Informationen wiederholt durch das Netzwerk leitet.
Sind LSTMs eine Art von RNN?
Ja, LSTMs (Long Short-Term Memory) sind eine spezielle, weiterentwickelte Art von RNN. Sie wurden entwickelt, um das Problem der langfristigen Abhängigkeiten zu lösen, mit dem einfache RNNs zu kämpfen haben, indem sie spezielle „Gate“-Mechanismen zur Steuerung des Informationsflusses verwenden.
Werden RNNs heute noch verwendet?
Ja, auch wenn für viele komplexe NLP-Aufgaben heute Transformer-Modelle bevorzugt werden, sind RNNs und ihre Varianten (LSTM, GRU) immer noch sehr relevant. Sie sind oft recheneffizienter und eine ausgezeichnete Wahl für viele Zeitreihenanalysen und andere sequenzielle Aufgaben.
Was ist das „Vanishing Gradient“-Problem?
Das „Vanishing Gradient“-Problem tritt beim Training von tiefen oder rekurrenten Netzen auf. Es beschreibt das Phänomen, dass der Fehlergradient bei der Rückpropagierung durch viele Schichten extrem klein wird, was dazu führt, dass das Netzwerk aufhört zu lernen, da die Gewichte kaum noch angepasst werden.