Ob Sie Ihr Smartphone per Gesichtsscan entsperren, durch Ihre Fotogalerie nach „Hund“ suchen oder von den Fortschritten in der medizinischen Diagnostik hören – Bilderkennung ist längst zu einem integralen Bestandteil unserer digitalen Welt geworden. Doch was steckt technisch dahinter? Wie schafft es eine Maschine, den Inhalt eines Bildes zu verstehen, das für sie zunächst nur eine Ansammlung von Pixeln ist?
Die Antwort liegt in einem faszinierenden Teilbereich der Künstlichen Intelligenz: der Deep Learning Bilderkennung. Dieser Artikel führt Sie durch die Kernkonzepte, zeigt Ihnen die Funktionsweise der zugrundeliegenden Technologie und beleuchtet die beeindruckenden Anwendungsmöglichkeiten, die Unternehmen heute schon nutzen.
[ads_custom_box title=“Auf einen Blick“ color_border=“#000000″]- Deep Learning Bilderkennung nutzt tiefe neuronale Netze, um visuelle Muster in Bildern zu interpretieren.
- Die Schlüsseltechnologie dahinter sind Convolutional Neural Networks (CNNs), die auf die Verarbeitung von Bilddaten spezialisiert sind.
- Ein typischer Prozess umfasst die Sammlung von Trainingsdaten, das Modelltraining und die Validierung der Ergebnisse.
- Die Qualität und Quantität der Trainingsdaten sind der entscheidende Faktor für die Genauigkeit des Modells.
- Anwendungsfälle reichen von der autonomen Steuerung über medizinische Analysen bis hin zu Sicherheitsanwendungen.
Was ist Deep Learning Bilderkennung eigentlich?
Deep Learning Bilderkennung ist eine Methode, bei der Computer darauf trainiert werden, visuelle Informationen aus digitalen Bildern oder Videos zu interpretieren und zu verstehen. Anstatt explizit programmiert zu werden, um bestimmte Objekte zu erkennen, lernen die Algorithmen selbstständig aus einer großen Menge an Beispieldaten. Sie identifizieren Muster, Merkmale und Zusammenhänge, um am Ende eine Vorhersage treffen zu können – etwa „Dieses Bild enthält eine Katze“ oder „Auf diesem Röntgenbild ist eine Anomalie sichtbar“.
Die Grundlage dafür bilden künstliche neuronale Netze, die von der Struktur des menschlichen Gehirns inspiriert sind. Im Kontext der Bilderkennung kommt dabei eine ganz spezielle Architektur zum Einsatz, die für diese Aufgabe prädestiniert ist.
Das Herzstück: Convolutional Neural Networks (CNNs)
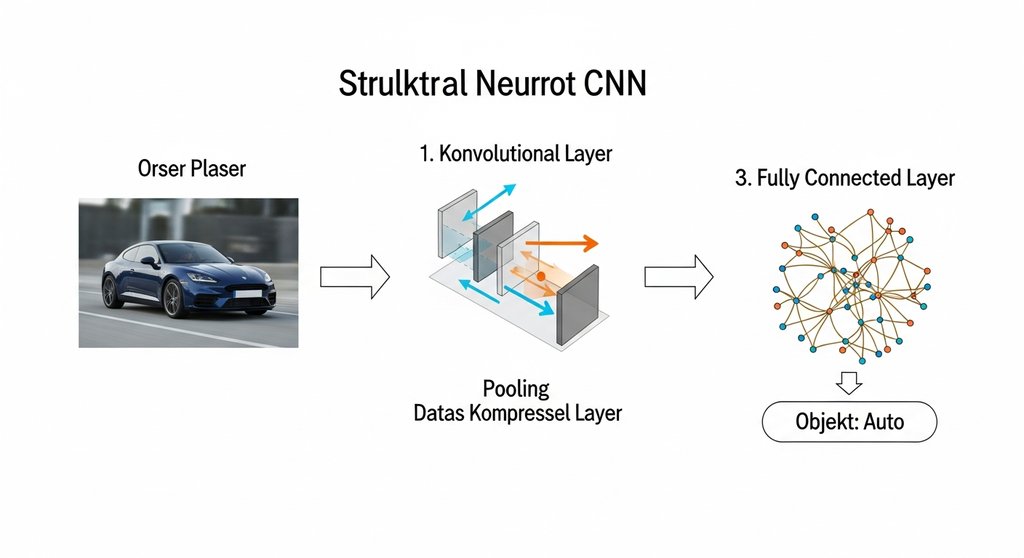
Der entscheidende Durchbruch in der Bilderkennung kam mit der Entwicklung von Convolutional Neural Networks (CNNs). Diese spezielle Art von neuronalem Netz ist darauf optimiert, hierarchische Muster in Bildern zu erkennen. Ein CNN zerlegt ein Bild schrittweise in seine Bestandteile – von einfachen Kanten und Ecken über Texturen bis hin zu komplexen Objekten wie Augen oder Rädern.
Aus meiner Sicht ist das Verständnis der Faltungs- (Convolution) und Pooling-Schichten der entscheidende Hebel, um die Funktionsweise von CNNs wirklich zu begreifen. Man kann es sich wie ein System aus spezialisierten Filtern vorstellen. Die ersten Filter erkennen grobe Linien, die nächsten kombinieren diese zu einfachen Formen und so weiter, bis das Netzwerk am Ende ein ganzes Objekt identifizieren kann.
Der Weg zum sehenden Computer: Ein typischer Workflow
Die Erstellung eines leistungsfähigen Bilderkennungsmodells folgt einem strukturierten Prozess, der sich in mehrere Phasen unterteilen lässt.
1. Die Grundlage: Hochwertige Trainingsdaten
Jedes Deep-Learning-Modell ist nur so gut wie die Daten, mit denen es trainiert wird. Die wichtigste Voraussetzung sind daher große und sorgfältig aufbereitete Trainingsdaten. Das bedeutet, Sie benötigen Tausende von Bildern, die bereits korrekt beschriftet (annotiert) sind. Für eine Katzen-Erkennung wären das also Bilder mit der Markierung „Katze“ und Bilder ohne Katze.
2. Das Training: Der Lernprozess des Modells
Während des Trainings wird dem Modell ein Bild aus dem Datensatz gezeigt. Es trifft eine Vorhersage, die mit der tatsächlichen Beschriftung verglichen wird. Ein Optimierungsalgorithmus wie der Backpropagation-Algorithmus passt daraufhin die internen Parameter des Netzwerks an, um den Fehler bei der nächsten Vorhersage zu minimieren. Dieser Prozess wird millionenfach wiederholt.
3. Die Validierung: Wie gut ist das Modell wirklich?
Nach dem Training wird die Leistung des Modells mit einem separaten Datensatz überprüft, den es zuvor noch nie gesehen hat. Dies stellt sicher, dass das Modell nicht nur auswendig gelernt hat, sondern generalisieren kann. Hierbei ist es entscheidend, sogenanntes Overfitting zu vermeiden, bei dem das Modell auf den Trainingsdaten perfekt, aber auf neuen Daten schlecht funktioniert.
4. Die Inferenz: Die Anwendung in der Praxis
Ist das Modell ausreichend trainiert und validiert, kann es für die eigentliche Aufgabe eingesetzt werden: die Analyse neuer, unbekannter Bilder in Echtzeit. Dieser Anwendungsschritt wird als Inferenz bezeichnet.
Konkrete Anwendungsfälle: Wo Bilderkennung heute schon Mehrwert schafft
Die Einsatzmöglichkeiten von Deep Learning Bilderkennung sind enorm und wachsen stetig. Hier sind einige der bedeutendsten Bereiche:
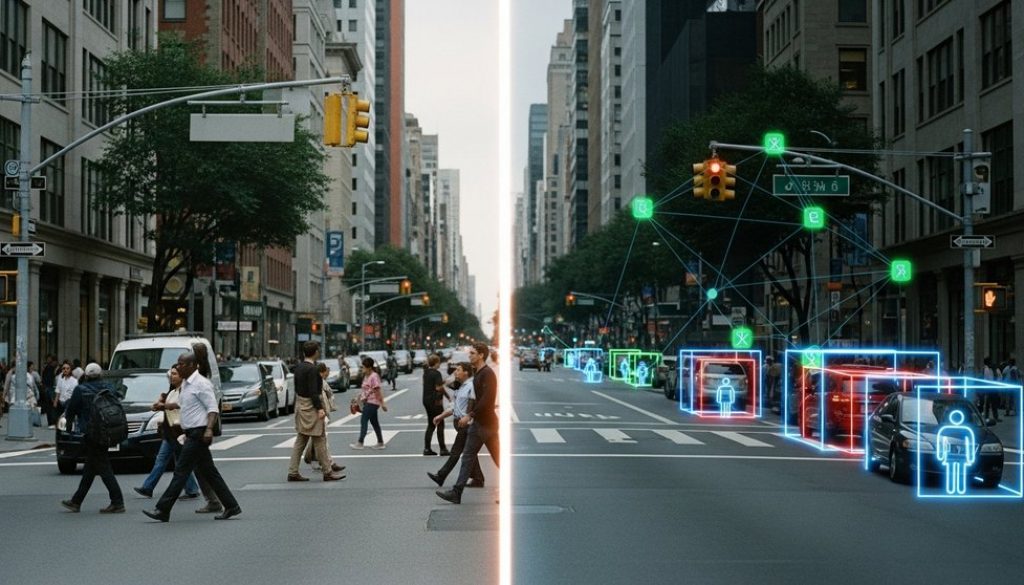
- Automobilindustrie: Autonome Fahrzeuge nutzen Bilderkennung zur Identifizierung von Fahrspuren, Verkehrszeichen, Fußgängern und anderen Fahrzeugen.
- Medizinische Bildanalyse: Die Technologie unterstützt Ärzte bei der Erkennung von Tumoren in MRT- oder CT-Scans oder bei der Analyse von Gewebeproben. Laut dem Fraunhofer IIS ermöglicht KI-gestützte Bildanalyse eine präzisere und schnellere Diagnostik in der Radiologie.
- Einzelhandel und Logistik: Automatisierte Kassensysteme erkennen Produkte ohne Scannen, und in Lagerhallen identifizieren Roboter Pakete für die Sortierung.
- Sicherheitstechnik: Gesichtserkennungssysteme zur Zutrittskontrolle oder zur Analyse von Videomaterial in öffentlichen Bereichen sind weit verbreitet.
Die Wahl der richtigen Werkzeuge: Frameworks & Bibliotheken
Glücklicherweise muss nicht jeder Entwickler das Rad neu erfinden. Leistungsstarke Open-Source-Frameworks stellen die notwendigen Werkzeuge für die Entwicklung von Deep-Learning-Modellen bereit. Im ewigen Duell TensorFlow vs. PyTorch haben sich zwei Hauptakteure etabliert, die von einer riesigen Community unterstützt werden.
Für einen einfacheren Einstieg bieten High-Level-APIs wie Keras eine vereinfachte Schnittstelle zu diesen Frameworks. In der Praxis hat sich immer wieder gezeigt, dass solche Werkzeuge die Entwicklungszeit drastisch verkürzen.
Fazit: Eine Technologie, die die Welt neu sehen lässt
Deep Learning Bilderkennung hat die Art und Weise, wie Maschinen mit der visuellen Welt interagieren, revolutioniert. Angetrieben von Convolutional Neural Networks und befeuert durch riesige Datenmengen, ist diese Technologie weit mehr als nur ein akademisches Konzept. Sie schafft heute bereits greifbaren Mehrwert in unzähligen Branchen.
Für Unternehmen bedeutet dies eine Chance für mehr Präzision, gesteigerte Effizienz und die Erschließung völlig neuer Möglichkeiten. Die Fähigkeit, Computern das Sehen beizubringen, ist einer der beeindruckendsten Fortschritte in der Geschichte der Künstlichen Intelligenz und des Deep Learning.
Häufig gestellte Fragen (FAQ)
Was ist der Unterschied zwischen Bilderkennung und Objekterkennung?
Bilderkennung (Image Classification) klassifiziert ein ganzes Bild, z.B. „Dieses Bild enthält eine Katze“. Objekterkennung (Object Detection) geht einen Schritt weiter und lokalisiert das Objekt im Bild, z.B. „Die Katze befindet sich in diesem markierten Bereich“.
Wie viele Bilder brauche ich zum Trainieren eines Modells?
Die genaue Anzahl hängt stark von der Komplexität der Aufgabe ab, aber oft sind es Tausende bis Millionen von Bildern. Durch die Nutzung von „Transfer Learning“, bei dem ein vortrainiertes Modell als Ausgangspunkt dient, kann diese Menge jedoch erheblich reduziert werden.
Ist Deep Learning Bilderkennung teuer?
Das Training komplexer Modelle kann aufgrund der benötigten Rechenleistung und der Kosten für die Datenerhebung teuer sein. Cloud-Anbieter und vortrainierte Modelle haben die Einstiegshürden jedoch gesenkt und machen die Technologie auch für kleinere Unternehmen zugänglich.
Kann ich Bilderkennung ohne Programmierkenntnisse nutzen?
Ja, es gibt mittlerweile Low-Code- oder No-Code-Plattformen, die es ermöglichen, Bilderkennungsmodelle über eine grafische Oberfläche zu trainieren und zu nutzen. Für tiefgreifende Anpassungen und anspruchsvolle Projekte sind jedoch Programmierkenntnisse unerlässlich.