Sie interagieren täglich mit Deep Learning, oft ohne es zu bemerken. Wenn Netflix Ihnen die nächste Serie vorschlägt, die Sie lieben werden, oder wenn Ihr Sprachassistent Ihre Anweisungen präzise versteht, steckt dahinter die Kraft des Deep Learning. Doch während der Begriff in aller Munde ist, bleibt das Konzept für viele ein abstraktes Mysterium. Was genau verbirgt sich hinter dieser Technologie, die ganze Branchen transformiert?
Dieser Artikel entmystifiziert Deep Learning. Wir führen Sie von den grundlegenden Definitionen über die entscheidenden Unterschiede zum klassischen Machine Learning bis hin zu den faszinierenden Anwendungsfällen, die schon heute die Welt verändern. Ziel ist es, Ihnen ein fundiertes Verständnis zu vermitteln, damit Sie die Potenziale dieser Technologie für sich und Ihr Unternehmen bewerten können.
- Definition: Deep Learning ist ein Teilbereich des maschinellen Lernens, der auf künstlichen neuronalen Netzen mit vielen Schichten („tiefen“ Netzen) basiert.
- Funktionsweise: Inspiriert vom menschlichen Gehirn, lernen diese Netze eigenständig Muster und Merkmale aus riesigen Datenmengen.
- Hauptvorteil: Im Gegensatz zum klassischen Machine Learning extrahiert Deep Learning relevante Merkmale automatisch, was den manuellen Aufwand drastisch reduziert.
- Anforderungen: Die Methode erfordert große Datenmengen und eine erhebliche Rechenleistung, um ihr volles Potenzial zu entfalten.
- Anwendungen: Die Einsatzgebiete reichen von Bild- und Spracherkennung über autonomes Fahren bis hin zur medizinischen Diagnostik.
Was ist Deep Learning? Eine verständliche Definition
Deep Learning (auf Deutsch „tiefgehendes Lernen“) ist eine spezialisierte Methode des maschinellen Lernens. Ihr Kernstück sind künstliche neuronale Netze, deren Struktur lose dem menschlichen Gehirn nachempfunden ist. Der Begriff „deep“ (tief) bezieht sich auf die große Anzahl von Schichten in diesen Netzen. Während einfache neuronale Netze vielleicht nur aus einer Eingabe-, einer versteckten und einer Ausgabeschicht bestehen, besitzen tiefe Netze Dutzende oder sogar Hunderte von versteckten Schichten.
Jede Schicht lernt, bestimmte Merkmale in den Daten zu erkennen. In den ersten Schichten werden einfache Muster identifiziert, wie Kanten oder Farben in einem Bild. Jede nachfolgende Schicht kombiniert die Informationen der vorherigen, um immer komplexere und abstraktere Merkmale zu lernen – zum Beispiel von Kanten zu Augen, von Augen zu Gesichtern. Dieser hierarchische Lernprozess ermöglicht es dem System, aus rohen Daten selbstständig Wissen zu extrahieren.
Der entscheidende Unterschied: Deep Learning vs. Machine Learning
Obwohl Deep Learning ein Teilbereich des Machine Learning ist, liegt der entscheidende Unterschied in der Art und Weise, wie die Modelle lernen. Bei klassischen Machine-Learning-Verfahren ist ein Prozess namens „Feature Engineering“ erforderlich. Das bedeutet, ein Experte muss die relevanten Merkmale der Daten manuell definieren und extrahieren, damit der Algorithmus überhaupt arbeiten kann. Soll ein System beispielsweise Katzen von Hunden unterscheiden, müsste der Experte dem Modell Merkmale wie Ohrenform, Schnauzenlänge oder Fellstruktur vorgeben.
Genau hier spielt Deep Learning seine größte Stärke aus. Ein Detail, das Anfänger oft übersehen, ist der massive Aufwand, der bei klassischen Machine-Learning-Projekten in eben jenes manuelle Feature Engineering fließt. Deep-Learning-Modelle automatisieren diesen Schritt vollständig. Sie benötigen lediglich die Rohdaten – in diesem Fall die Bilder von Katzen und Hunden – und lernen die unterscheidenden Merkmale eigenständig innerhalb ihrer vielschichtigen Netzwerkstruktur. Aus meiner Sicht ist genau das der entscheidende Hebel, der die jüngsten Durchbrüche in der KI erst ermöglicht hat.
Diese Fähigkeit zur automatischen Merkmalsextraktion macht Deep Learning besonders leistungsfähig bei der Verarbeitung von unstrukturierten Daten wie Bildern, Videos, Tonaufnahmen oder natürlicher Sprache. Während die Leistung klassischer Modelle mit zunehmender Datenmenge oft stagniert, skalieren Deep-Learning-Systeme exzellent: Mehr Daten führen fast immer zu besseren Ergebnissen.
Wie funktioniert Deep Learning in der Praxis? Der Lernprozess entschlüsselt
Stellen Sie sich vor, Sie bringen einem Kind bei, einen Apfel zu erkennen. Sie zeigen ihm Hunderte von Bildern von Äpfeln – rote, grüne, große, kleine. Mit jedem Bild lernt das Kind, die gemeinsamen Merkmale zu abstrahieren. Der Lernprozess eines Deep-Learning-Modells funktioniert ganz ähnlich, ist aber Teil des umfassenderen Feldes der Künstlichen Intelligenz. Es wird mit einem riesigen Datensatz „trainiert“, der aus Beispielen und den dazugehörigen korrekten Ergebnissen besteht (z.B. Bilder und deren Bezeichnungen). Das Ziel: Das Netzwerk soll seine internen Parameter so anpassen, dass es bei neuen, unbekannten Daten korrekte Vorhersagen trifft.
Die Bausteine: Neuronen, Schichten und Gewichte
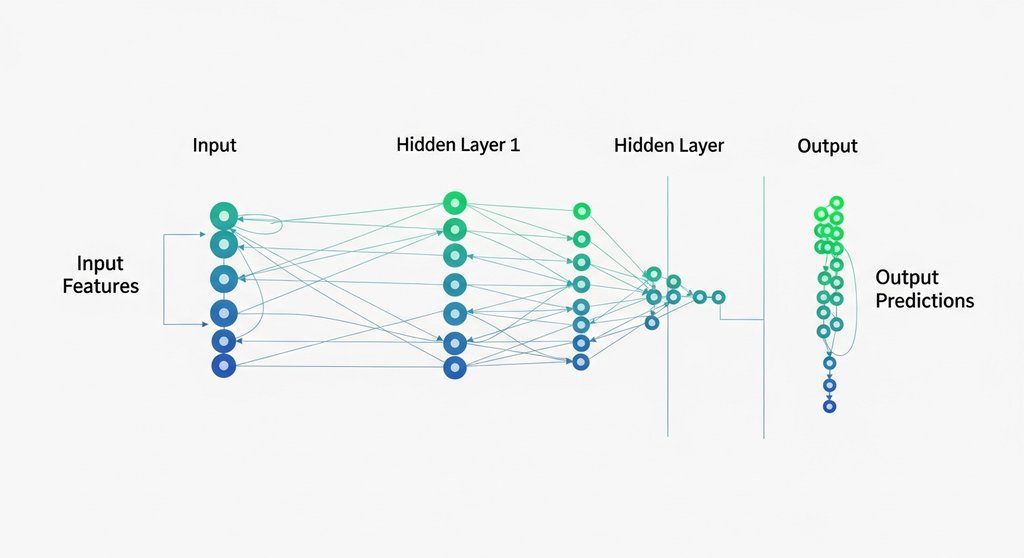
Das Herzstück eines Deep-Learning-Modells ist das künstliche Neuron. Jedes Neuron empfängt Signale von anderen Neuronen, gewichtet diese nach ihrer Wichtigkeit und gibt basierend auf einer Aktivierungsfunktion ein eigenes Signal weiter. Diese Neuronen sind in Schichten organisiert:
- Die Eingabeschicht: Sie nimmt die rohen Daten auf, zum Beispiel die Pixel eines Bildes.
- Die versteckten Schichten: Hier findet die eigentliche „Magie“ statt. Jede Schicht erkennt zunehmend komplexere Muster in den Daten, die von der vorherigen Schicht weitergegeben wurden.
- Die Ausgabeschicht: Sie liefert das Endergebnis, beispielsweise die Wahrscheinlichkeit, dass das Bild eine Katze zeigt.
Die „Tiefe“ des Netzwerks ergibt sich aus der Anzahl dieser versteckten Schichten, die es dem Modell ermöglichen, extrem komplexe Zusammenhänge zu lernen.
Der Trainingsprozess: Von Fehlern lernen mit Backpropagation
Der Trainingsprozess ist ein iterativer Zyklus, der darauf abzielt, die Vorhersagefehler des Modells zu minimieren. Das geschieht in der Regel durch einen Prozess namens Backpropagation (Rückpropagierung des Fehlers).
Dieser Zyklus aus Vorhersage, Fehlerberechnung und Anpassung wird millionenfach wiederholt, bis das Modell eine zufriedenstellende Genauigkeit erreicht. In der Praxis hat sich immer wieder gezeigt, dass die Wahl der richtigen Architektur und der Trainingsparameter – wie Lernrate oder die Anzahl der Epochen – entscheidend für den Erfolg ist. Es ist weniger eine exakte Wissenschaft als vielmehr eine Mischung aus Erfahrung, Theorie und Experimentieren. Die dabei entstehenden komplexen Modelle sind auch ein zentraler Gegenstand aktueller Sicherheitsforschung, wie das BSI in seinem Grundlagenpapier zu KI hervorhebt.
Anwendungsbereiche: Wo Deep Learning heute schon die Welt verändert
Die wahre Faszination von Deep Learning liegt nicht in der Theorie, sondern in der praktischen Anwendung. Die Fähigkeit, aus riesigen Datenmengen selbstständig zu lernen, hat eine Welle von Innovationen ausgelöst, die längst in unserem Alltag angekommen sind. Von der Art, wie wir kommunizieren, bis hin zur medizinischen Diagnostik – die folgenden Beispiele zeigen, wo diese Technologie bereits heute einen entscheidenden Unterschied macht.
Bild- und Objekterkennung: Die Welt mit digitalen Augen sehen
Einer der spektakulärsten Erfolge des Deep Learning ist die Bilderkennung. Modelle, insbesondere sogenannte Convolutional Neural Networks (CNNs), erreichen mittlerweile eine Präzision, die in vielen Fällen die des menschlichen Auges übertrifft. Dies ermöglicht eine Vielzahl von Anwendungen:
- Gesichtserkennung: Sie entsperrt nicht nur Ihr Smartphone, sondern sichert auch Gebäude oder beschleunigt Grenzkontrollen.
- Autonomes Fahren: Fahrzeuge erkennen in Echtzeit Fußgänger, Verkehrszeichen und andere Autos, um sichere Entscheidungen zu treffen.
- Medizinische Diagnostik: Algorithmen analysieren MRT- oder Röntgenbilder und identifizieren Tumore oder andere Anomalien oft früher und zuverlässiger als menschliche Experten.
- Industrielle Qualitätskontrolle: Kamerasysteme prüfen am Fließband Produkte auf winzigste Fehler, die für einen Menschen kaum sichtbar wären.
Meiner Erfahrung nach ist gerade die automatisierte visuelle Qualitätskontrolle einer der schnellsten und profitabelsten Einstiegspunkte für produzierende Unternehmen. Der Return on Investment stellt sich hier oft schon nach kurzer Zeit ein, da Ausschuss reduziert und die Produktqualität nachhaltig gesteigert wird. Die Technologie übersetzt hier ein technisches Merkmal in den direkten emotionalen Vorteil von Verlässlichkeit und Markenstärke.
Natürliche Sprachverarbeitung (NLP): Die Brücke zwischen Mensch und Maschine
Deep Learning hat die Art und Weise, wie Maschinen menschliche Sprache verstehen und generieren (Natural Language Processing), revolutioniert. Modelle wie Transformer können komplexe semantische Zusammenhänge in Texten erfassen. Diese Fähigkeit ist das Fundament für die explosionsartige Entwicklung, die wir bei Generativer KI beobachten.
Konkrete Anwendungen sind beispielsweise fortschrittliche Chatbots, die personalisierten Kundenservice bieten, Echtzeit-Übersetzungsdienste, die Sprachbarrieren mühelos überwinden, oder die Sentiment-Analyse, die aus Tausenden von Kundenrezensionen automatisch die allgemeine Stimmungslage extrahiert. Die Integration solcher Tools wird zu einem zentralen Baustein jeder zukunftsfähigen KI-Strategie für Unternehmen, um Kundennähe und Effizienz zu maximieren.
Empfehlungssysteme: Was der Kunde als Nächstes will
Wenn Ihnen Streaming-Dienste eine Serie vorschlagen oder E-Commerce-Plattformen das passende Zubehör anzeigen, steckt dahinter ein Deep-Learning-Algorithmus. Diese Empfehlungssysteme analysieren Ihr bisheriges Verhalten und vergleichen es mit dem von Millionen anderer Nutzer, um hochpräzise Vorhersagen zu treffen. Das Ziel ist es, Ihnen Inhalte oder Produkte zu präsentieren, die für Sie maximal relevant sind.
Diese Personalisierung führt nicht nur zu einer besseren Nutzererfahrung, sondern ist ein massiver wirtschaftlicher Hebel: Sie erhöht die Verweildauer, die Kundenbindung und den Umsatz. Für Entscheidungsträger ist es daher entscheidend, die Grundlagen dieser Systeme zu verstehen, was ein gutes Machine Learning für Manager Training vermitteln kann. Es geht darum, das Potenzial für das eigene Geschäftsmodell zu erkennen und strategisch zu nutzen.
Herausforderungen und Grenzen: Kein Allheilmittel
Trotz seiner beeindruckenden Leistungsfähigkeit ist Deep Learning keine magische Lösung für alle Probleme. Die Technologie bringt spezifische Herausforderungen mit sich, deren Kenntnis für eine realistische Einschätzung und erfolgreiche Implementierung entscheidend ist. Wer die Potenziale heben will, muss auch die Hürden kennen.
Der „Black Box“ Charakter: Das Problem der Intransparenz
Viele Deep-Learning-Modelle sind extrem komplex. Das führt zum sogenannten „Black Box“-Problem: Wir können das Ergebnis einer Entscheidung sehen (z.B. „Kreditantrag abgelehnt“), aber nicht immer nachvollziehen, wie genau das Modell zu diesem Schluss gekommen ist. Aus meiner Sicht ist das Management dieses Risikos, besonders in kritischen Bereichen wie der Medizin oder im Finanzwesen, eine der zentralen Aufgaben, um Vertrauen in KI-Systeme aufzubauen und regulatorische Anforderungen zu erfüllen.
Datenhunger und Rechenleistung: Die hohen Anforderungen
Deep Learning ist datenintensiv. Um effektiv zu lernen, benötigen die Modelle riesige Mengen an qualitativ hochwertigen Trainingsdaten. Gleichzeitig erfordert das Training selbst eine enorme Rechenleistung, die meist nur durch spezielle Hardware (GPUs) erbracht wird. Viele Unternehmen nutzen daher Cloud-Plattformen, was wiederum eine durchdachte Strategie für die Cloud Security erfordert, um Daten und Modelle zu schützen.
Verzerrungen (Bias) und ethische Bedenken
Ein KI-Modell ist nur so gut wie die Daten, mit denen es trainiert wird. Sind die Trainingsdaten unausgewogen oder spiegeln sie gesellschaftliche Vorurteile wider, wird das Modell diese Verzerrungen (Bias) lernen und reproduzieren. Dies kann zu diskriminierenden Ergebnissen führen. Der verantwortungsvolle Umgang mit KI ist daher keine Option, sondern eine Notwendigkeit, wie es auch das Fraunhofer-Institut betont. Gesetze wie der EU AI Act schaffen hierfür einen rechtlichen Rahmen, und die Einhaltung der DSGVO für Unternehmen ist beim Umgang mit personenbezogenen Trainingsdaten ohnehin fundamental.
Fazit: Deep Learning ist keine Magie, sondern eine strategische Notwendigkeit
Deep Learning hat sich von einem akademischen Konzept zu einer treibenden Kraft der digitalen Transformation entwickelt. Die Fähigkeit, eigenständig komplexe Muster in riesigen Datenmengen zu erkennen, löst Probleme, die zuvor als unlösbar galten. Es automatisiert die mühsame Merkmalsextraktion und ermöglicht Durchbrüche in Bilderkennung, Sprachverarbeitung und Vorhersagemodellen.
Gleichzeitig ist der Einsatz von Deep Learning mit Herausforderungen verbunden – von der Intransparenz über den Ressourcenbedarf bis hin zu ethischen Fragen. Der erfolgreiche Weg führt über eine bewusste Auseinandersetzung mit diesen Hürden. Für Unternehmen geht es darum, die Potenziale zu Erkennen, die Mechanismen zu Verstehen und strategisch zu Handeln, um im Wettbewerb von morgen bestehen zu können.
Häufig gestellte Fragen
Was ist der Hauptunterschied zwischen KI, Machine Learning und Deep Learning?
Stellen Sie es sich wie russische Matroschka-Puppen vor: Künstliche Intelligenz (KI) ist der äußerste, umfassende Bereich. Maschinelles Lernen (ML) ist eine Teildisziplin der KI, bei der Systeme aus Daten lernen. Deep Learning wiederum ist eine spezialisierte Methode des ML, die besonders tiefe neuronale Netze verwendet.
Benötigt jedes Unternehmen Deep Learning?
Nicht zwingend. Die Wahl der Methode hängt vom Problem, der Datenverfügbarkeit und den Ressourcen ab. Für viele Anwendungsfälle, insbesondere bei strukturierten Daten und kleineren Datensätzen, sind klassische Machine-Learning-Verfahren oft effizienter und leichter zu interpretieren.
Wie fängt man mit Deep Learning im eigenen Unternehmen an?
Beginnen Sie mit einem klar definierten Geschäftsproblem, nicht mit der Technologie. Bewerten Sie anschließend die Qualität und Quantität Ihrer Daten und starten Sie mit einem überschaubaren Pilotprojekt. Oft ist die Nutzung von vorgefertigten KI-Services auf Cloud-Plattformen ein pragmatischer und kosteneffizienter erster Schritt.
Ist Deep Learning sicher?
Die Sicherheit von Deep-Learning-Modellen ist ein aktives Forschungsfeld. Sie können anfällig für gezielte Angriffe sein (z.B. Adversarial Attacks), die zu Fehlentscheidungen führen. Ein umfassender Plan für den Incident Response ist daher entscheidend, um im Ernstfall schnell und strukturiert handeln zu können.