Stellen Sie sich ein Gehirn vor, das nur in geraden Linien denken kann. Es könnte addieren und multiplizieren, aber niemals komplexe Muster erkennen oder kreative Verbindungen herstellen. Genau das ist ein neuronales Netz ohne Aktivierungsfunktionen: ein leistungsstarkes, aber fundamental eingeschränktes System. Viele Entwickler übernehmen Standardfunktionen wie ReLU, ohne deren Zweck oder Alternativen wirklich zu verstehen.
Dieser Ansatz führt oft zu suboptimalen Modellen, längeren Trainingszeiten und schwer diagnostizierbaren Fehlern. Die Wahl der Aktivierungsfunktion ist kein Nebenschauplatz, sondern eine entscheidende Weichenstellung für den Erfolg Ihres Projekts. In diesem Artikel entmystifizieren wir diese Kernkomponente des Deep Learning, zeigen Ihnen die wichtigsten Funktionen und geben klare Anleitungen für die richtige Auswahl.
[ads_custom_box title=“Auf einen Blick“ color_border=“#000000″] * Aktivierungsfunktionen führen Nicht-Linearität in neuronale Netze ein und ermöglichen so das Erlernen komplexer Muster.* Sie bestimmen, basierend auf der gewichteten Summe der Eingaben, ob und wie stark ein künstliches Neuron „feuert“.
* Die Wahl der Funktion (z.B. ReLU, Sigmoid, Tanh) hat direkten Einfluss auf die Lerngeschwindigkeit und die Gesamtleistung des Modells.
* Moderne Architekturen setzen vorwiegend auf ReLU und dessen Varianten aufgrund ihrer Effizienz und der Lösung des Vanishing-Gradient-Problems.
[/ads_custom_box]
Was sind Aktivierungsfunktionen und warum sind sie entscheidend?
Eine Aktivierungsfunktion ist eine mathematische Formel, die am Ende eines jeden Neurons in einem neuronalen Netz sitzt. Ihre Aufgabe ist es, den Output dieses Neurons zu bestimmen. Sie nimmt die summierte und gewichtete Eingabe aller vorherigen Neuronen entgegen und transformiert diesen Wert in ein Ausgabesignal. Dieses Signal wird dann an die nächste Schicht von Neuronen weitergegeben.
Ihre wichtigste Eigenschaft ist jedoch die Einführung von Nicht-Linearität. Ohne eine nicht-lineare Aktivierungsfunktion wäre ein mehrschichtiges neuronales Netz mathematisch äquivalent zu einem einschichtigen Netz. Es könnte nur lineare Beziehungen modellieren, was seine Fähigkeit, komplexe Daten wie Bilder, Sprache oder Markttrends zu verstehen, drastisch einschränken würde. Die Aktivierungsfunktionen sind der Schlüssel, der die „tiefen“ Schichten erst wirklich leistungsfähig macht.
Die wichtigsten Aktivierungsfunktionen im Überblick
Im Laufe der Zeit haben sich verschiedene Funktionen etabliert, von denen einige heute als historisch gelten, während andere den aktuellen Stand der Technik darstellen. Ein Verständnis der gängigsten Typen ist für jeden KI-Praktiker unerlässlich.
Die Klassiker: Sigmoid und Tanh
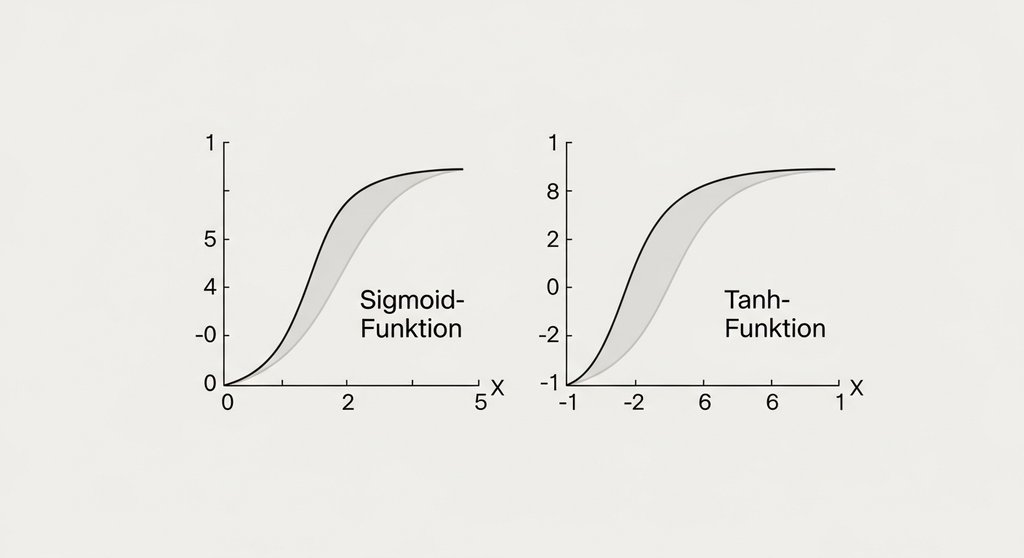
Die Sigmoid-Funktion war eine der ersten weitverbreiteten Aktivierungsfunktionen. Sie quetscht jeden beliebigen reellen Eingabewert in einen Bereich zwischen 0 und 1. Das macht sie besonders nützlich für die Ausgabeschicht bei binären Klassifikationsproblemen, wo das Ergebnis eine Wahrscheinlichkeit darstellen soll (z. B. „Ist das eine Katze?“ Ja/Nein).
Die Funktion des hyperbolischen Tangens (Tanh) ist der Sigmoid-Funktion sehr ähnlich, bildet die Werte aber auf einen Bereich zwischen -1 und 1 ab. Ihr Vorteil ist, dass ihr Output um den Nullpunkt zentriert ist, was dem Lernprozess, dem sogenannten Backpropagation-Algorithmus, in den nachfolgenden Schichten helfen kann. Beide Funktionen leiden jedoch unter dem gleichen, gravierenden Problem: dem Vanishing Gradient. Bei sehr hohen oder sehr niedrigen Eingabewerten wird ihre Ableitung fast null, was das Lernen in tiefen Netzen extrem verlangsamt oder ganz stoppt.
Meiner Erfahrung nach sind Sigmoid und Tanh heute in den tiefen, versteckten Schichten moderner Architekturen kaum noch anzutreffen. Der Vanishing-Gradient-Effekt ist in der Praxis einfach ein zu großes Problem. Für die Ausgabeschicht bei bestimmten Klassifikationsproblemen haben sie aber weiterhin ihre absolute Berechtigung.
Der Game-Changer: ReLU (Rectified Linear Unit)
Die Einführung von ReLU war ein Wendepunkt für das Deep Learning. Ihre Definition ist verblüffend einfach: `f(x) = max(0, x)`. Ist die Eingabe positiv, wird sie unverändert weitergegeben. Ist sie negativ, ist der Output null. Diese Einfachheit macht sie rechnerisch extrem effizient.
Der entscheidende Vorteil von ReLU ist jedoch, dass sie für positive Werte eine konstante Ableitung von 1 hat. Dadurch wird das Vanishing-Gradient-Problem effektiv gelöst und ein wesentlich schnelleres und stabileres Training von sehr tiefen Netzen ermöglicht. Ein Nachteil ist das „Dying ReLU“-Problem: Wenn ein Neuron einmal einen negativen Input erhält und seine Gewichte so angepasst werden, dass es immer nur negative Werte bekommt, wird es quasi „sterben“ und nie wieder aktiviert.
Die Evolution von ReLU: Leaky ReLU, PReLU und ELU
Um das „Dying ReLU“-Problem zu beheben, wurden mehrere Varianten entwickelt:
- Leaky ReLU: Diese Funktion gibt bei negativen Werten nicht null zurück, sondern einen kleinen, vordefinierten negativen Wert (z. B. 0.01 * x). Dadurch können Neuronen auch im negativen Bereich noch lernen und „sterben“ nicht.
- Parametric ReLU (PReLU): Hier ist der Faktor für den negativen Bereich kein fester Wert, sondern ein Parameter, den das Netzwerk während des Trainings selbst lernt. Das bietet mehr Flexibilität.
- Exponential Linear Unit (ELU): ELU verhält sich ähnlich wie ReLU, geht aber für negative Werte in eine sanfte Sättigung über. Sie kann zu besseren Ergebnissen führen, ist aber rechenintensiver als ReLU.
Wie wählen Sie die richtige Aktivierungsfunktion aus?
Die Auswahl der passenden Funktion scheint komplex, folgt aber in der Praxis einigen bewährten Heuristiken. Eine falsche Wahl kann die Modell-Performance erheblich beeinträchtigen und sogar das Overfitting begünstigen.
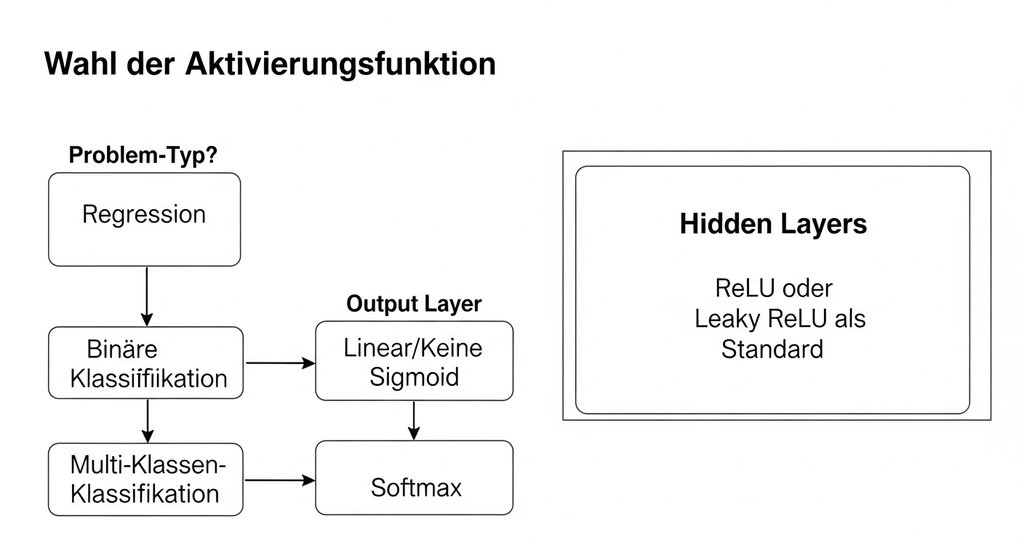
Ein Detail, das Anfänger oft übersehen, ist die strikte Trennung zwischen der Wahl für die versteckten Schichten (Hidden Layers) und der Ausgabeschicht (Output Layer). Die Funktion der Ausgabeschicht ist nicht beliebig, sondern wird direkt vom Problemtyp diktiert. Eine falsche Funktion hier, und das ganze Training war vergeblich.
Regeln für die Praxis
- Starten Sie mit ReLU: Für alle versteckten Schichten ist ReLU oder Leaky ReLU fast immer die beste und sicherste erste Wahl.
- Ausgabeschicht bei Regression: Wenn Sie einen kontinuierlichen Wert vorhersagen (z. B. einen Preis), verwenden Sie keine Aktivierungsfunktion (oder eine lineare Identitätsfunktion).
- Ausgabeschicht bei binärer Klassifikation: Hier ist die Sigmoid-Funktion die Standardwahl, um eine Wahrscheinlichkeit zwischen 0 und 1 zu erhalten.
- Ausgabeschicht bei Multi-Klassen-Klassifikation: Nutzen Sie die Softmax-Funktion. Sie verwandelt die Ausgaben in eine Wahrscheinlichkeitsverteilung über alle Klassen, deren Summe 1 ergibt.
Aktuelle Forschungen, wie eine Analyse im Springer Fachmagazin für KI-Forschung, bestätigen immer wieder die Überlegenheit von ReLU-Varianten in den meisten Szenarien für versteckte Schichten.
Aktivierungsfunktionen in spezifischen Architekturen
In bestimmten spezialisierten Architekturen haben sich klare Präferenzen für Aktivierungsfunktionen herauskristallisiert, die optimal auf deren Funktionsweise abgestimmt sind.
In Convolutional Neural Networks (CNNs), die primär für die Bildverarbeitung eingesetzt werden, ist ReLU die unangefochtene Standardwahl für die Convolutional Layers. Ihre Effizienz und die Fähigkeit, das Vanishing-Gradient-Problem zu umgehen, sind hier besonders wertvoll.
Bei Recurrent Neural Networks (RNNs), die für die Verarbeitung von Sequenzdaten wie Text oder Zeitreihen konzipiert sind, war traditionell Tanh sehr verbreitet. In modernen Architekturen wie LSTMs und GRUs kommen jedoch intern komplexere Gating-Mechanismen zum Einsatz, die oft auf einer Kombination von Sigmoid- und Tanh-Funktionen basieren.
Fazit: Der Funke, der Ihr Netzwerk zum Leben erweckt
Aktivierungsfunktionen sind weit mehr als nur mathematische Details. Sie sind der Funke, der Ihrem Netzwerk das Denken beibringt. Die richtige Wahl beschleunigt das Training, verbessert die Genauigkeit und verhindert häufige Fehler. Beginnen Sie mit ReLU, verstehen Sie die Anforderungen Ihrer Ausgabeschicht und scheuen Sie sich nicht, mit den moderneren Varianten zu experimentieren, um das letzte Quäntchen Leistung aus Ihrem Modell herauszuholen.
Häufig gestellte Fragen
Kann man verschiedene Aktivierungsfunktionen in einem Netz mischen?
Ja, das ist sogar Standard. Typischerweise verwendet man eine Funktion wie ReLU in allen versteckten Schichten und eine andere, zum Problem passende Funktion (z.B. Sigmoid oder Softmax) in der Ausgabeschicht.
Was genau ist die Softmax-Funktion?
Softmax ist eine Aktivierungsfunktion für die Ausgabeschicht bei Multi-Klassen-Klassifikationsproblemen. Sie wandelt einen Vektor von Zahlen (Logits) in eine Wahrscheinlichkeitsverteilung um, bei der jeder Wert zwischen 0 und 1 liegt und die Summe aller Werte 1 ergibt.
Warum wird Sigmoid kaum noch in versteckten Schichten verwendet?
Der Hauptgrund ist das Vanishing-Gradient-Problem. Die Ableitung der Sigmoid-Funktion ist für die meisten Eingabewerte sehr klein, was das Training von tiefen Netzwerken extrem verlangsamt, da die Fehlerinformationen nicht mehr effektiv durch die Schichten zurückpropagiert werden.
Was passiert, wenn man gar keine Aktivierungsfunktion verwendet?
Ohne nicht-lineare Aktivierungsfunktionen kann das Netzwerk nur lineare Transformationen lernen. Egal wie viele Schichten Sie hinzufügen, das gesamte Netzwerk verhält sich wie ein einziges lineares Modell und kann keine komplexen Muster in den Daten erkennen.